À propos du formidable nouveau livre de Ben Recht
Traduction de AI has limits, even if many AI people can’t see them, par Henry Farrell, le 6 avril 2026.
Vers la fin de son nouveau livre, The Irrational Decision, Ben Recht explique ce qu’il s’est fixé comme objectif.
La plupart des ouvrages consacrés à la technologie prennent soit le parti de considérer que toute technologie est mauvaise, soit celui de considérer que toute technologie est bonne. Ce n’est pas le cas de cet ouvrage. Ces livres se concentrent trop sur les méfaits et pas assez sur les limites. Or, les limites sont plus enrichissantes. Tout au long de l’ouvrage, j’ai soutenu que la rationalité mathématique est limitée quant aux types de problèmes qu’elle est la mieux à même de résoudre, mais qu’elle possède des points forts qui ont donné lieu à des avancées technologiques remarquables.
Il se peut que davantage de livres sur la technologie échappent à la dichotomie bien-mal que ne le laisse entendre Ben. Malgré tout, je n’ai lu aucun autre ouvrage qui soit aussi utile pour expliquer pourquoi et dans quels cas la vaste famille d’approches que nous appelons (peut-être malheureusement) IA fonctionne, et pourquoi et dans quels cas elle ne fonctionne pas. Ben (qui est un ami) allie une profonde compréhension des technologies à une maîtrise de l’histoire et à une capacité à écrire clairement et bien sur des sujets complexes. J’ai beaucoup appris de ce livre. Il y a de fortes chances que vous en appreniez autant.
La dichotomie bien-mal décrite par Ben façonne en effet une grande partie de notre débat actuel autour de la « rationalité mathématique » et de l’IA. Concernant la première, le livre de Nate Silver, On The Edge, défend les types de rationalité bayésienne dont les gens de la Silicon Valley aiment parler. Il fait l’éloge du « courant » de ceux qui appréhendent le monde en termes de probabilités statistiques, que l’on actualise dès que de nouvelles informations sont disponibles. Comme Ben le suggère dans un autre essai critique coécrit avec Leif Weatherby, ce « courant » regroupe le poker professionnel, la pensée rationaliste sur l’IA, les paris sportifs et les élucubrations des crypto-bro en un tout qui semble plus ou moins cohérent, voire brillant, si l’on n’y regarde pas de trop près. Comme le suggère Ben, les rationalistes de cette tendance ont tendance à supposer que « les ordinateurs peuvent prendre de meilleures décisions que les humains » et sont souvent de fervents partisans de l’IA (Silver, pour être honnête, n’est pas aussi fervent que certains autres). D’autres livres, comme The AI Con d’Emily Bender et Alex Hanna, partent d’une hypothèse diamétralement opposée : que la plupart de ce que nous appelons « IA » n’est que du battage médiatique. Bender et Hanna nous expliquent que si l’on commence à fouiller derrière le grand spectacle et la voix tonitruante des « maths mathématiques », on découvre le sorcier plutôt peu impressionnant de l’apprentissage automatique, qui n’est en réalité capable que d’un correcteur orthographique sophistiqué, indiquant aux radiologues quelles parties d’une image ils pourraient vouloir examiner, et d’autres activités « bien délimitées » de ce genre.
Ni le rationalisme de l’IA ni la pensée de l’AI-Con ne sont d’une grande aide pour expliquer les technologies auxquelles nous sommes confrontés aujourd’hui. Le premier a tendance à sombrer dans la fantaisie, démontrant à maintes reprises comment partir de prémisses ridicules permet d’aboutir à des résultats tout aussi ridicules. Le second a tendance à se transformer en déni, affirmant de plus en plus fort que les technologies mal-aimées sont inutiles alors même qu’elles trouvent de plus en plus d’applications. Nous devrions nous inquiéter beaucoup plus des affirmations des triomphalistes que de celles des négationnistes, car ils sont bien plus influents. Mais pour réussir à déjouer leurs affirmations, nous avons besoin d’une perspective plus réaliste sur ce dont l’IA et les technologies connexes sont capables que celle que peuvent fournir les négationnistes.
The Irrational Decision fournit de solides raisons d’être sceptique quant aux aspirations grandioses du projet rationaliste, tout en expliquant pourquoi l’apprentissage automatique a des applications remarquables dans son domaine d’application approprié. Ceux qui sont le plus étroitement impliqués dans le projet rationaliste ont du mal à en comprendre les limites, car ces limites façonnent leur propre vision du monde. L’astuce étrange du rationalisme consiste à recomposer des problèmes complexes en termes qui peuvent être facilement rationalisés. Quand cela fonctionne, c’est très, très bien, mais quand cela ne fonctionne pas, c’est horrible. Pour comprendre cela, il faut d’abord comprendre d’où vient le rationalisme.
*******
Une grande partie de la discussion dans The Irrational Decision est historique. Elle remonte aux années 1940 et 1950 pour déterminer d’où vient réellement le rationalisme, offrant un bref historique qui ressemble un peu à ce qu’aurait pu être l’ouvrage d’Erickson et al., How Reason Almost Lost Its Mind, s’il s’était davantage concentré sur les statistiques et la recherche opérationnelle que sur l’économie. L’objectif de Ben dans tout cela est d’identifier comment la « rationalité mathématique » est devenue un ensemble relativement cohérent d’idées sur la manière dont nous pourrions mieux organiser la société.
L’histoire qu’il raconte est nécessairement confuse, mais certains thèmes généraux importants se dégagent, notamment autour du développement de la théorie de l’optimisation. La programmation linéaire permet de trouver des moyens optimaux d’allouer des ressources dans le cadre d’un budget limité, pour autant que les contraintes soient linéaires (lorsqu’elles ne le sont pas, un véritable cauchemar computationnel peut s’ensuivre). La théorie du contrôle optimal permet à un système de contrôle de s’adapter de manière optimale à son environnement (là encore, sous des hypothèses restrictives concernant les contraintes). La théorie des jeux peut postuler – et souvent même découvrir – des stratégies optimales pour affronter des adversaires dans des situations stratégiques. Ces boîtes à outils se recoupent avec d’autres. Une famille de techniques, allant du recuit simulé aux formes ancestrales de la descente de gradient/rétropropagation sur lesquelles repose le « deep learning », offre des moyens de découvrir des optima locaux supérieurs dans des situations plus complexes. Les essais cliniques randomisés (ECR) ont fourni des moyens possibles de déterminer si une intervention donnée (un médicament ; une mesure politique) fonctionnait ou non.
Toutes ces approches suggèrent la supériorité des formes techniques d’analyse sur les jugements humains. Les ECR appliquent des protocoles et des analyses statistiques pour tenter de découvrir des relations causales (selon le discours standard), ou de justifier des interventions (selon celui de Ben). D’autres approches impliquent la découverte de solutions optimales, à partir d’hypothèses mathématiques et de simplifications pratiques. D’autres encore impliquent la découverte d’optima locaux (c’est-à-dire : des solutions meilleures que d’autres qui sont facilement visibles dans leur voisinage), qui peuvent être meilleures que celles auxquelles des humains ordinaires pourraient parvenir.
Les approches rationalistes sont très puissantes dans leurs domaines d’application appropriés, mais il faut avoir une idée de ce que sont ces domaines. Ben suggère qu’il existe un « point idéal » pour de nombreux outils computationnels, voire la plupart d’entre eux. Par exemple, les statistiques ne sont pas utiles dans les situations où un traitement fonctionne toujours (pourquoi aurait-on besoin d’outils d’inférence compliqués), ou lorsque les résultats sont trop variables et imprévisibles, mais bien dans la zone confuse entre les deux. Lorsque vous atteignez l’espace où vos outils ont une emprise sur la réalité malgré leurs imperfections, vous pouvez accomplir des choses extraordinaires. Par exemple, dans sa propre critique du livre, Dan Davies évoque
la boucle de rétroaction incroyablement productive entre « les algorithmes d’optimisation sont très exigeants en termes de traitement informatique » et « les algorithmes d’optimisation sont très utiles pour concevoir des ordinateurs meilleurs et plus rapides ».
Comme le décrit Ben, les concepteurs ont réussi à réduire les défis incroyablement complexes de la conception de puces à une tâche optimisable en formulant des hypothèses simplificatrices sur les « cellules standard » et en les combinant avec des algorithmes de recuit simulé capables de découvrir des optimums qui, autrement, ne seraient pas facilement visibles. Cela a alors permis, selon Dan, de développer des puces plus rapides, qui à leur tour pouvaient exécuter des algorithmes plus puissants, et ainsi de suite, dans une boucle.
Mais considérer le rationalisme comme un outil universel de découverte est problématique, d’autant plus que ces techniques sont intrinsèquement limitées ou partent d’hypothèses simplificatrices peu plausibles. Daphne Koller, l’une des chercheuses décrites par Ben, a découvert des moyens étonnamment efficaces de réduire la complexité du poker afin de le rendre plus « soluble ». Mais Koller a finalement abandonné l’étude de la théorie des jeux :
« Comprendre le monde qui nous entoure est plus important que de comprendre la meilleure façon de bluffer », m’a-t-elle dit. D’après son expérience, lorsqu’elle devait modéliser des personnes dans des simulations de systèmes complexes, le fait de modéliser leurs décisions comme aléatoires lui permettait d’atteindre 90 % de la solution. La manière de prendre les meilleures décisions dans un contexte d’incertitude généralisée était bien moins évidente. Pour Koller, une fois que l’on s’éloignait du plateau de jeu et que l’on devait prendre des décisions dans la réalité, comprendre l’incertitude et les innombrables façons dont elle pouvait surgir et affecter les plans était plus important que la stratégie.
Il s’est avéré que les algorithmes de poker généraient eux aussi des boucles de rétroaction, non pas en simplifiant la conception des jetons, mais en simplifiant les êtres humains (le livre de C. Thi Nguyen, The Score, fournit un compte rendu plus complet de la façon dont cela fonctionne). Dans un sens important, la théorie du poker optimal a moins bien réussi à optimiser le poker qu’à optimiser les joueurs de poker, inspirant un style de jeu dans lequel les professionnels « ont commencé à mémoriser les tables de valeurs attendues issues des solveurs de poker afin de pouvoir jouer de manière « optimale selon la théorie des jeux » dans les grands tournois de poker ». Peut-être peut-on décrire cela comme une amélioration dans les affaires humaines. Pour ma part, je ne le vois pas ainsi.
*******
Comprendre le rationalisme mathématique nous aide à saisir les forces et les limites de l’IA. Il ne s’agit pas seulement d’une forme de rationalisme, mais de l’application combinée d’une variété de techniques rationalistes établies de longue date — les réseaux neuronaux (qui remontent aux années 1950), l’apprentissage statistique et la rétropropagation — rendue possible par des ordinateurs plus puissants et d’énormes quantités de données facilement accessibles. La méthodologie de Claude Shannon pour modéliser le langage, qui constitue la base intellectuelle des « grands modèles linguistiques », est « un exemple de reconnaissance statistique de formes » ou d’apprentissage automatique. Et l’apprentissage automatique lui-même n’est ni plus ni moins qu’un puissant outil statistique. J’ai trouvé que ce passage était peut-être l’explication la plus claire de ce qu’il fait que j’aie jamais lue.
Pour illustrer le problème typique de l’apprentissage automatique, j’aime imaginer un tableur hypothétique. Chaque ligne du tableur correspond à une unité ou à un exemple. Mais je me moque de ce que signifient ces unités. Je sais juste que j’ai un tas de colonnes remplies de données. Et on me dit qu’une de ces colonnes est spéciale. Je suis sur le point de recevoir une multitude de nouvelles lignes dans le tableur, mais quelqu’un en bas a oublié de remplir la colonne spéciale. La direction m’a chargé d’écrire une formule pour remplir ce qui devrait s’y trouver. Pour une raison quelconque, je ne peux pas voir ces nouvelles lignes et je dois construire la formule à partir de la feuille de calcul dont je dispose. La formule peut utiliser toutes sortes d’opérations de feuille de calcul : elle peut attribuer des pondérations à différentes colonnes et additionner les scores, elle peut utiliser des formules logiques basées sur le fait que certaines colonnes dépassent des valeurs particulières, elle peut diviser et multiplier. … Je vais faire une expérience. Je vais prendre la dernière ligne de ma feuille de calcul et faire comme si je n’avais pas la colonne spéciale. Je vais écrire autant de formules que possible. … Mais pourquoi choisir cette dernière ligne en particulier ? Je peux faire quelque chose de similaire pour chaque ligne ! Je vais inventer un ensemble de fonctions plausibles. Je vais évaluer leur capacité de prédiction sur la feuille de calcul dont je dispose. Je vais choisir la fonction qui maximise la précision. C’est plus ou moins l’art de l’apprentissage automatique.
Deviner les lignes manquantes des feuilles de calcul et optimiser s’avère avoir beaucoup d’applications utiles : pas seulement les modèles linguistiques, mais aussi le repliement des protéines, la reconnaissance de l’écriture manuscrite et une myriade d’autres applications. De même, l’apprentissage automatique n’est qu’une autre forme d’optimisation et/ou de prédiction. Une très grande partie du modèle économique actuel de la Silicon Valley consiste à prendre des situations complexes qui ne ressemblent pas à des problèmes d’optimisation ou de prédiction, à les simplifier et à les redécrire, puis à trouver des solutions.
Tout comme les statistiques, l’apprentissage automatique a son « point idéal ». Il n’est pas utile dans les situations où l’on dispose d’une abstraction mathématique véritablement claire, que l’on peut transformer en code exécutable. Il n’est pas non plus utile dans les situations trop désordonnées ou compliquées pour être prévisibles (il s’agit, après tout, d’une application de techniques statistiques). On souhaite l’utiliser dans les situations intermédiaires où il n’existe pas de solution claire et évidente, mais où les techniques d’apprentissage automatique, bien que lourdes et coûteuses en termes de calcul, peuvent découvrir une approximation utile, même si l’on ne comprend pas tout à fait sur quoi elle repose ni comment elle fonctionne.
*******
Tout cela soulève d’importants problèmes d’évaluation. Comment savoir dans quels cas l’apprentissage automatique est une approche utile ? Comment déterminer quelle approche d’apprentissage automatique est la meilleure à appliquer pour un problème donné ? Et derrière tout cela se cache la question plus large par laquelle nous avons commencé. Comment savoir quand les techniques d’apprentissage automatique en général (ou d’autres raccourcis rationalistes) sont meilleures ou pires que le jugement humain ordinaire ?
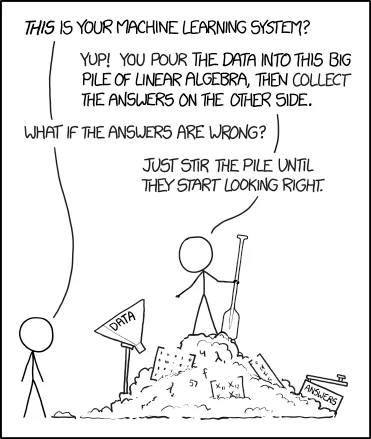
La réponse à la première question est malheureusement indéterminée. D’après ce que je comprends de l’argument de Ben, la seule véritable façon de découvrir si l’apprentissage automatique fonctionne pour un type de problème donné est de trouver une solution d’apprentissage automatique qui fonctionne. Il n’existe pas de moyen ex ante véritablement satisfaisant de distinguer les problèmes que l’apprentissage automatique peut résoudre de ceux qu’il ne peut pas résoudre. De plus, comme Ali Rahimi et Ben l’ont fait remarquer ailleurs, les praticiens de l’IA s’appuient davantage sur de l’« alchimie » que sur une compréhension approfondie des raisons pour lesquelles certaines approches fonctionnent et d’autres non. Plus succinctement, XKCD :
Quant à savoir comment déterminer quels algorithmes d’apprentissage automatique fonctionnent mieux que d’autres, les informaticiens ont mis au point une approche communément appelée Common Task Framework (ou ses variantes). Créer un ensemble de données commun (classiquement : des photos de chats et de chiens) et en partager la totalité (ou, ce qui est bien plus courant de nos jours, une partie) avec différentes équipes de chercheurs. Ensuite, définir une tâche commune pouvant être effectuée sur ces données et évaluée de manière assez simple (l’algorithme est-il capable de distinguer les chats des chiens). Les différentes équipes peuvent alors proposer des algorithmes qui s’affrontent dans un esprit de compétition, lesquels peuvent éventuellement être testés sur des données qui n’ont pas été rendues publiques, afin d’éviter le surajustement et l’apprentissage ciblé sur le test. L’algorithme qui fonctionne le mieux (c’est-à-dire qui présente le pourcentage de précision le plus élevé pour distinguer les chats des chiens) est, ipso facto, le meilleur algorithme pour cette tâche.
Ce qui nous amène à l’une des principales contributions du livre de Ben. De nombreux acteurs du domaine de l’IA affirment que ce cadre peut être utilisé pour répondre à une question fondamentale : les algorithmes d’IA sont-ils généralement supérieurs aux êtres humains dans l’exécution d’un ensemble de tâches cognitives ? Il existe toute une série de tests de tâches courantes censés répondre à cette question, dont certains portent des noms qui… soulèvent des questions. Si vous fréquentez les bons (ou les mauvais) endroits sur Internet, vous lirez régulièrement telle ou telle affirmation alarmiste selon laquelle l’humanité est vouée à être supplantée en raison des performances de l’IA à tel ou tel test.
Ben suggère que de telles affirmations commettent souvent une erreur fondamentale. Il décrit certains résultats célèbres issus des recherches du psychologue Paul Meehl sur les décisions médicales et autres, qui suggéraient que « les prévisions statistiques fournissaient des jugements plus précis sur l’avenir que les jugements cliniques » dans certaines conditions. Mais la conclusion à laquelle Ben parvient n’est pas que cela signifie que les prévisions statistiques sont généralement meilleures que le jugement d’un expert. Au contraire, elles sont meilleures lorsqu’il existe des résultats clairement définis, de bonnes données et des cas de référence clairs pouvant servir de comparaison. Il existe de nombreuses situations où cela n’est pas vrai et ne peut pas facilement l’être.
Si nous utilisons des approches basées sur des types de tâches courantes pour mesurer le succès, nous faisons pencher la balance en faveur des tâches pouvant être décrites en termes de résultats clairs et testées avec de bonnes données, et au détriment de celles qui ne présentent pas ces caractéristiques. Ben décrit cela de manière encore plus incisive. Les tâches pouvant être définies de cette manière sont, par définition, celles que les ordinateurs ou autres approches automatisées seront capables d’accomplir rapidement mieux que les êtres humains. Paradoxalement :
Si nous pouvons mesurer pourquoi les humains pourraient être capables de surpasser les machines, alors nous pouvons construire des machines capables de surpasser les humains. En revanche, si nous ne pouvons pas articuler clairement un ensemble précis d’actions, de résultats, de mesures et de métriques, alors nous ne pouvons pas mécaniser la résolution de problèmes. C’est cette numérisation, cette traduction du monde dans le langage de l’ordinateur, qui est nécessaire à l’automatisation.
L’univers des tâches ayant des objectifs, des conditions et des données clairs est à la fois l’univers des tâches facilement mesurables et celui des tâches que les ordinateurs et les processus automatisés peuvent bien exécuter. L’une de ces caractéristiques prédit plus ou moins l’autre. C’est donc ce qui rend si difficile pour les rationalistes mathématiques de percevoir les limites de leur perspective. Les outils et les mesures qu’ils utilisent pour comprendre et résoudre les problèmes auraient presque pu être conçus exprès pour confirmer leurs préjugés intellectuels généraux en dissimulant les problèmes que leurs méthodes ne peuvent pas résoudre facilement.
*******
Cela nous aide à situer le débat qui a lieu actuellement au sujet de l’IA. Il existe de nombreux passionnés d’IA qui croient qu’elle peut être appliquée pour accomplir pratiquement n’importe quelle tâche que les humains peuvent faire, aussi bien que les humains, voire mieux. Y parvenir n’est qu’une question d’échelle et d’ingénierie, et cela va se produire très bientôt. Il y a des sceptiques de l’IA, qui soutiennent que ses avantages se limitent à un éventail restreint de tâches bien définies, voire (j’entends régulièrement cette affirmation, bien qu’elle soit rarement défendue de manière particulièrement sophistiquée) que ces avantages sont inexistants. Ces positions se traduisent souvent par « l’IA est bonne » et « l’IA est mauvaise », dans la lignée de ce que suggère l’IA.
Comme l’indique la citation au début de cet article, Ben ne se penche pas vraiment sur la question de savoir si l’IA est bonne ou mauvaise d’un point de vue général. Il propose plutôt qu’elle puisse accomplir de nombreuses tâches, y compris des tâches que nous ne pouvons pas encore anticiper, mais qu’il y a des limites. L’IA, à l’instar de la rationalité mathématique plus généralement, a un point d’équilibre : des problèmes suffisamment complexes pour ne pas pouvoir être résolus par d’autres approches moins coûteuses en termes de calcul, mais qui présentent suffisamment de régularités pour être traitables. À l’intérieur de ce point d’équilibre, elle peut accomplir des choses extraordinaires. En dehors de ce point d’équilibre, elle peut être redondante ou complètement inutile. Et il existe une zone ambiguë entre les deux, où elle peut faire des choses, mais de manière imparfaite.
Il n’est pas possible, sauf en termes très généraux, de définir ex ante ce qu’est ce point idéal. Des ingénieurs ingénieux tentent sans cesse de l’élargir. Les voitures autonomes constituent un exemple de problème qui s’est avéré bien plus difficile à résoudre que ne le pensaient les ingénieurs (comme le dit Ben : « nous ne savons pas comment traduire la notion de “bon conducteur” en un résultat statistique clair »), mais ils abordent le problème par la force brute, de sorte que la conduite autonome est bien plus plausible dans différents environnements qu’auparavant. De même, il existe de très nombreux cas limites. Une façon de traiter bon nombre d’entre eux pourrait être d’essayer de les simplifier jusqu’à les faire disparaître, par exemple en n’ayant que des voitures autonomes, sans les imprévisibilités liées aux conducteurs humains, aux cyclistes, ou… ou… ou). Une telle simplification est une version de ce que les cybernéticiens du management appellent la « réduction de la variété ».
De même, il existe des défis qui semblent fondamentalement résistants à la rationalité mathématique, notamment la bureaucratie et la politique :
les sociétés ne sont pas des puces informatiques. Bien que j’aie noté au chapitre 2 que les puces informatiques étaient souvent comparées à des villes microscopiques, celles-ci ont toujours été conçues pour être hermétiquement scellées et parfaitement contrôlées. C’est ce qui les rendait optimisables. Les sociétés réelles, en revanche, comptaient des personnes. S’il est pratique de modéliser et de considérer la population, sa santé et ses flux de marché comme des abstractions mathématiques, celles-ci se heurtent aux limites du désordre que les gens introduisent.
Dans The Sciences of the Artificial, Herbert Simon avance un argument étroitement lié :
Lorsque nous en venons à la conception de systèmes aussi complexes que des villes, des bâtiments ou des économies, nous devons renoncer à l’objectif de créer des systèmes qui optimiseront une fonction d’utilité hypothétique, et nous devons nous demander si les différences de style du type de celles que je viens de décrire ne représentent pas des variantes hautement souhaitables dans le processus de conception plutôt que des alternatives à évaluer comme « meilleures » ou « pires ». La diversité, dans les limites de contraintes satisfaisantes, peut être une fin souhaitable en soi, entre autres parce qu’elle nous permet d’accorder de la valeur à la recherche autant qu’à son résultat — de considérer le processus de conception comme une activité valorisante en soi pour ceux qui y participent.
Nous avons généralement considéré l’urbanisme comme un moyen par lequel l’activité créative de l’urbaniste pouvait construire un système susceptible de satisfaire les besoins d’une population. Peut-être devrions-nous considérer l’urbanisme comme une activité créative précieuse à laquelle de nombreux membres d’une communauté peuvent avoir l’occasion de participer — si nous avons l’intelligence d’organiser le processus de cette manière.
Comme l’explique James Scott dans Seeing Like a State1En français : L’Oeil de l’État, les problèmes commencent lorsque les technocrates traitent les êtres humains et les sociétés complexes qu’ils créent comme s’il s’agissait de « cellules standard » simplifiées pouvant être facilement réorganisées selon des schémas plus optimaux. De plus, comme Ben le dit ailleurs (Cosma et moi-même citons cela dans notre prochain article sur l’IA et la bureaucratie), les désaccords politiques résistent généralement à l’optimisation. Lorsque vous êtes confronté à des compromis incommensurables (même très simples : faut-il utiliser l’argent de votre budget pour financer une aire de jeux afin de satisfaire les parents, ou une caserne de pompiers pour réduire le risque d’incendie des commerces ?), vous vous éloignez définitivement du type de problèmes que l’apprentissage automatique, ou l’optimisation plus généralement, peut simplifier de manière utile.
Dès lors que nous ne parvenons pas à nous mettre d’accord sur une fonction de coût, on ne voit pas clairement ce que notre mécanisme d’optimisation… nous apporte. L’optimisation multi-objectifs implique nécessairement un compromis. Et on ne peut pas optimiser un compromis.
À moins du développement d’approches radicalement différentes, il n’y a aucune raison de croire que la politique atteindra le juste équilibre. Mais de nombreux rationalistes mathématiques soutiennent le contraire (par exemple cette série d’affirmations2Un article en effet assez naïf que j’ai traduit Construire une superintelligence politique, qui mériterait peut-être une réponse détaillée à part entière). Si vous voulez vraiment comprendre les limites de l’IA, vous vous devez de lire le livre de Ben. Il existe de nombreux ouvrages sur la technologie qui sont intelligents dans un certain sens, mais très peu qui soient sages. Celui-ci fait partie de ces très rares exceptions.
Liste évolutive des traductions par Gilles en vrac
Les caractères gras dans le texte sont de Gilles.
Notes
- 1En français : L’Oeil de l’État, ↩︎
- 2Un article en effet assez naïf que j’ai traduit Construire une superintelligence politique ↩︎